W dniach 24–29 października 2026 r. w Budapeszcie odbyła się konferencja EMNLP 2026 (Conference on Empirical Methods in Natural Language Processing) – jedno z najważniejszych międzynarodowych wydarzeń naukowych poświęconych przetwarzaniu języka naturalnego. Podczas konferencji została zaprezentowana praca pt. „Multi-Model Framework for Sentiment Annotation: A Use Case of Multilingual Wikipedia]”. Artykuł przedstawia metodę automatycznego oznaczania wydźwięku tekstu, która wykorzystuje zgodność ocen kilku modeli sztucznej inteligencji w celu zwiększenia wiarygodności uzyskiwanych wyników.
Tradycyjne, ręczne oznaczanie danych tekstowych jest czasochłonne i kosztowne, dlatego coraz częściej wykorzystuje się do tego duże modele językowe (LLM). Ich oceny nie zawsze są jednak stabilne – ten sam tekst może otrzymać różne etykiety w zależności od zastosowanego modelu lub kolejnego uruchomienia analizy. Aby ograniczyć ten problem, autorzy zaproponowali rozwiązanie, w którym trzy modele językowe (GPT-5.2, Gemini 3.1 Pro i Claude Opus 4.6) pełnią funkcję niezależnych anotatorów. Każdy z nich trzykrotnie oceniał wydźwięk tych samych zdań, określając go jako pozytywny, neutralny lub negatywny, z możliwością wskazania przypadków trudnych do jednoznacznej klasyfikacji. Za szczególnie wiarygodne uznawano etykiety, w przypadku których wszystkie dziewięć ocen było zgodnych. Metodę przetestowano na zdaniach pochodzących ze wstępnych części artykułów Wikipedii w pięciu językach: angielskim, niemieckim, hiszpańskim, polskim i rosyjskim. Wybór Wikipedii nie był przypadkowy – jej artykuły powinny zachowywać neutralny punkt widzenia, co sprawia, że rozpoznawanie subtelnych różnic w wydźwięku tekstu stanowi interesujące wyzwanie badawcze.
Wyniki pokazały, że pełną zgodność wszystkich dziewięciu ocen uzyskano dla około 71-76% analizowanych zdań, w zależności od języka. Współczynnik Kappa Fleissa, mierzący stopień zgodności między anotatorami z uwzględnieniem zgodności przypadkowej, wyniósł od 0,72 do 0,76, co wskazuje na wysoki poziom zgodności ocen. Dodatkowo wyniki modeli porównano z ocenami ludzi na wybranych próbach zdań w języku polskim i angielskim. W przypadkach spełniających rygorystyczne kryterium jednomyślności uzyskano pełną zgodność z ocenami ludzkimi. Wynik ten potwierdza potencjał zaproponowanej metody, choć nie oznacza, że modele są bezbłędne we wszystkich sytuacjach. Badanie ujawniło również istotne ograniczenie – pojedyncze modele wyraźnie gorzej radziły sobie z rozpoznawaniem wydźwięku negatywnego, zwłaszcza w tekstach o przeważnie neutralnym charakterze.
Ważnym rezultatem badań jest także wielojęzyczny zbiór ponad 75 tys. zdań z przypisanymi etykietami wydźwięku oraz informacją o stopniu zgodności ocen modeli. Zbiór został publicznie udostępniony w serwisie Hugging Face i może być wykorzystywany w dalszych badaniach nad automatyczną analizą tekstu. Zaproponowane podejście pokazuje, w jaki sposób współpraca kilku modeli językowych może wspierać tworzenie dużych zbiorów danych, zwiększając powtarzalność i wiarygodność procesu adnotacji.
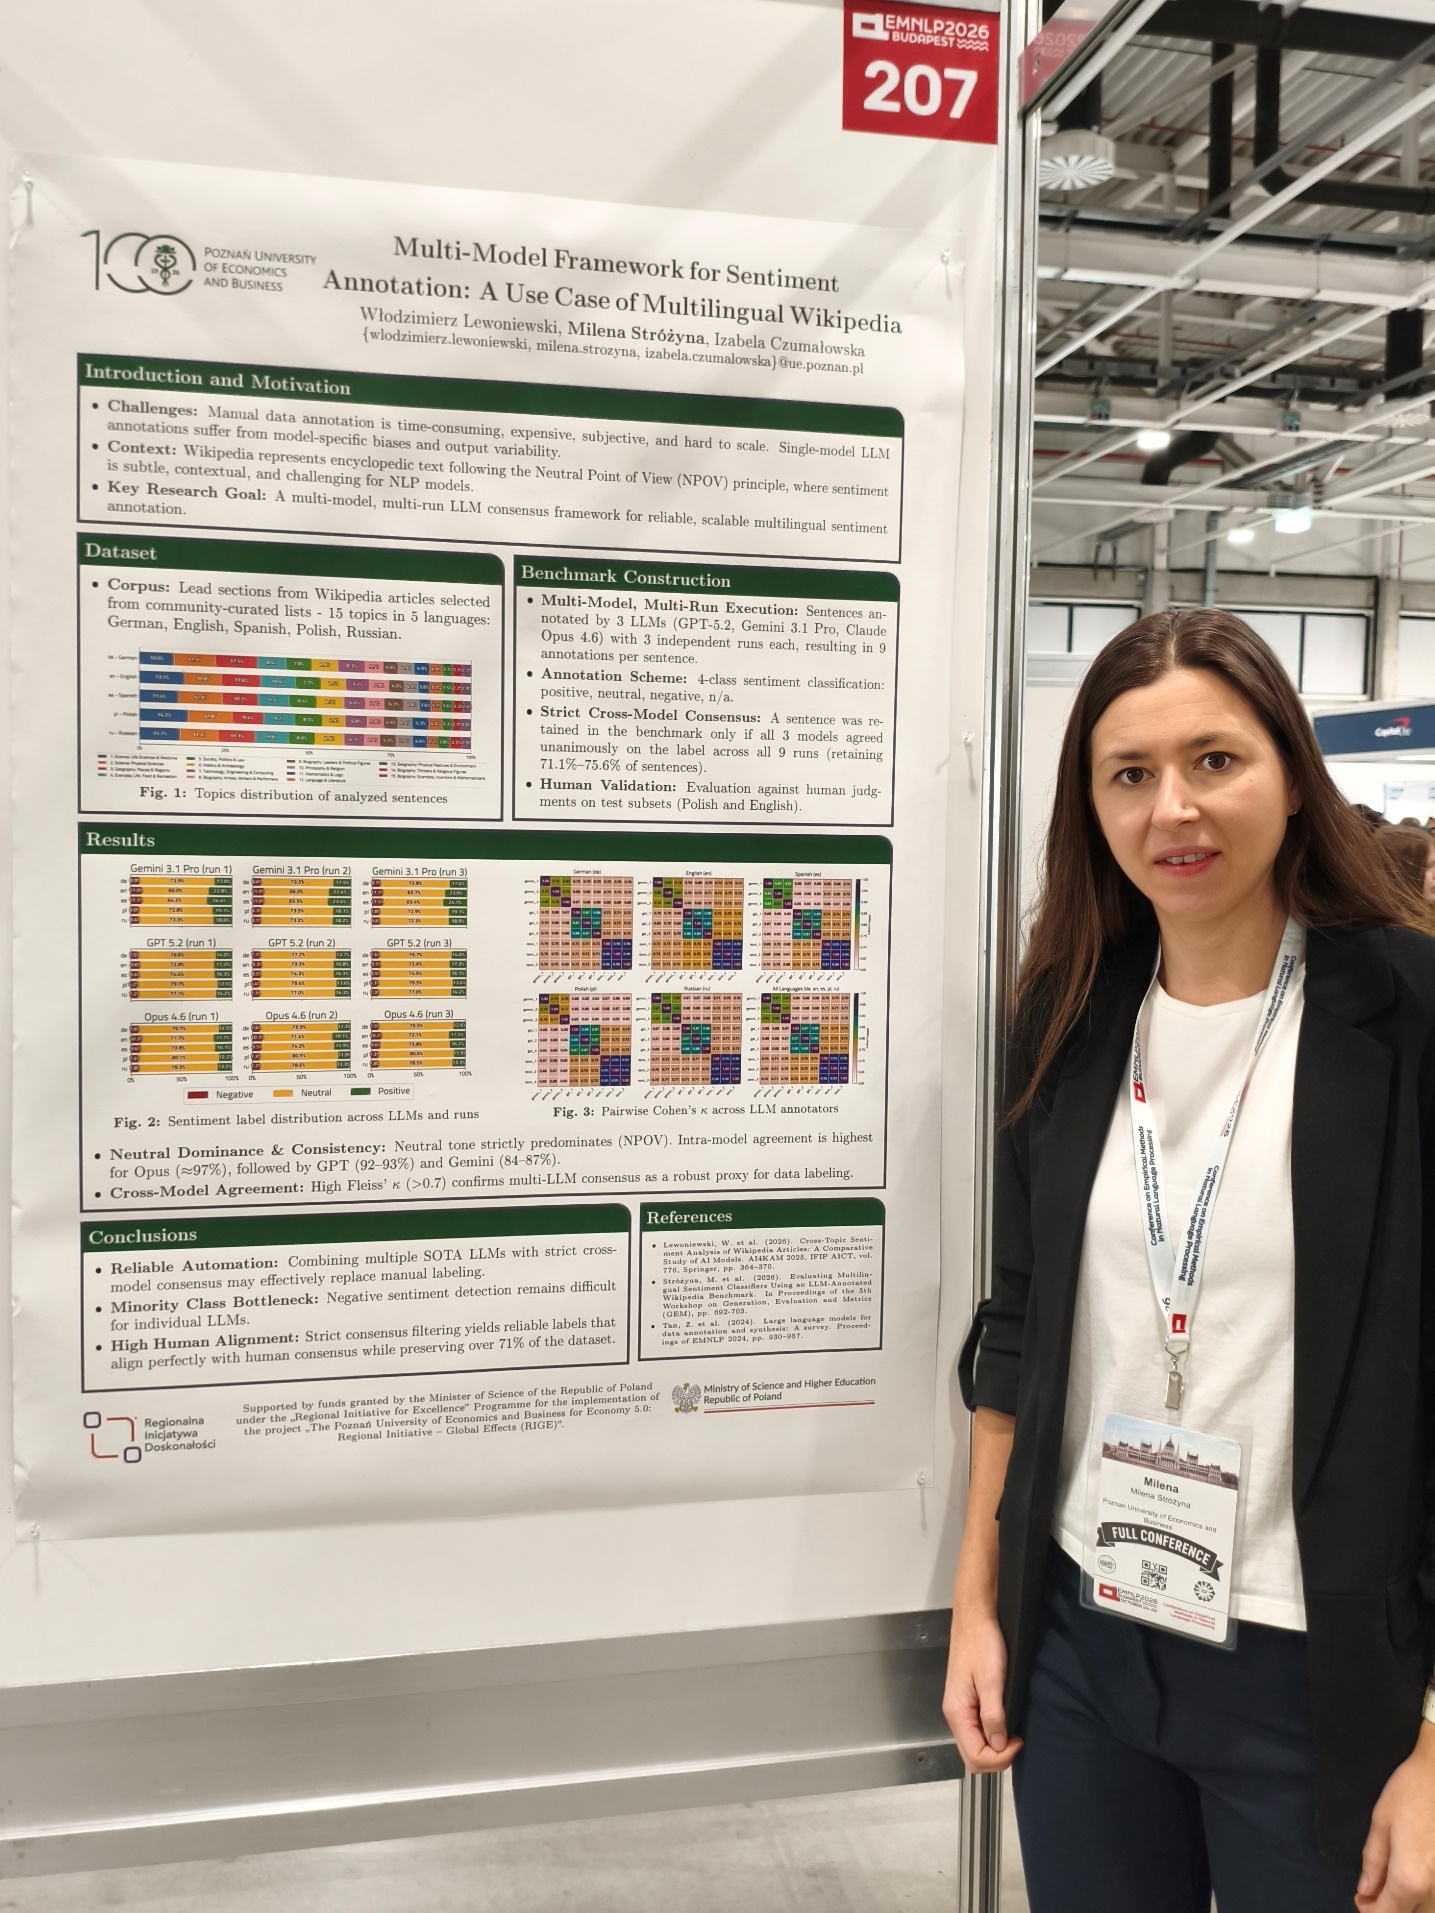
Autorami publikacji są dr Włodzimierz Lewoniewski, dr Milena Stróżyna oraz mgr Izabela Czumałowska. Artykuł ukazał się w tomie „Findings of the Association for Computational Linguistics: EMNLP 2026”. Jego pełny tekst jest dostępny w bibliotece naukowej ACL Anthology. DOI: 10.18653/2026.findings-emnlp.1830
EMNLP to coroczna konferencja organizowana przez SIGDAT, grupę tematyczną działającą w ramach Association for Computational Linguistics (ACL). Należy do najbardziej prestiżowych wydarzeń naukowych w dziedzinie przetwarzania języka naturalnego i posiada najwyższą kategorię A* w rankingu CORE. Edycja 2026 odbyła się w centrum kongresowo-wystawienniczym HUNGEXPO w Budapeszcie.